Como construir em 2026 knowledge base
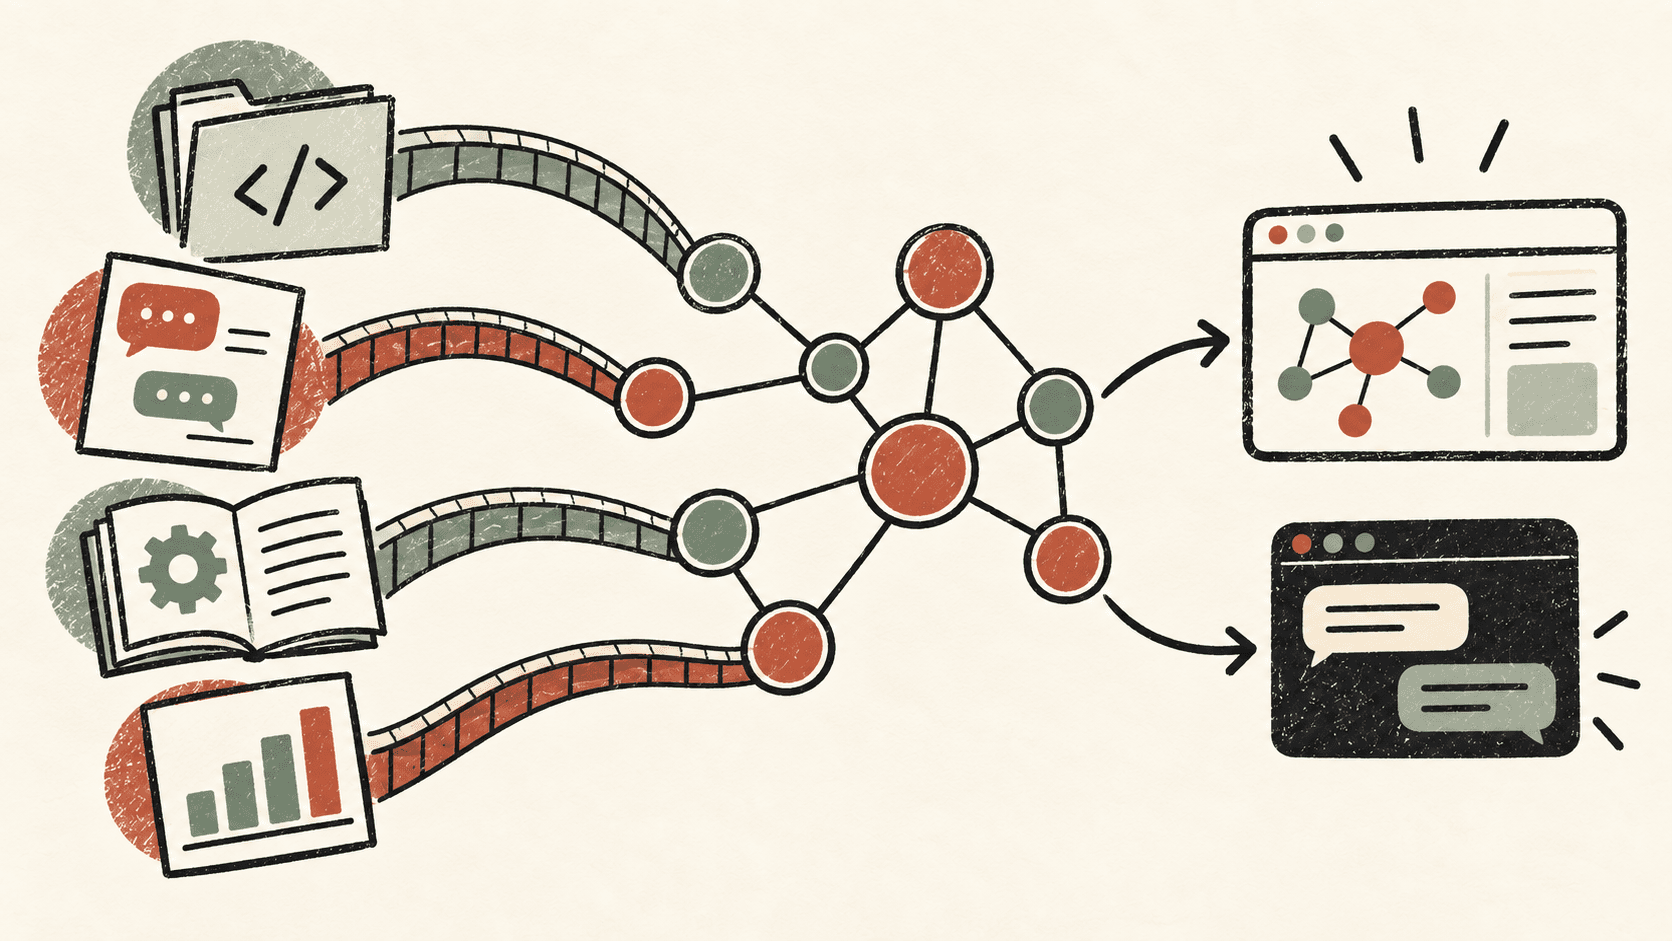
Toda empresa de tecnologia acumula conhecimento mais rápido do que consegue organizá-lo.
Uma parte está no código. Outra está na documentação, nos tickets, nas decisões arquiteturais, no catálogo do produto e nas conversas que registram problemas reais. Cada sistema conhece bem o seu pedaço, mas quase nenhum consegue responder perguntas que atravessam todos eles.
Foi desse problema que nasceu o Cobli Intelligence: uma camada interna que transforma fontes separadas em um grafo de conhecimento pesquisável e o disponibiliza tanto para pessoas quanto para agentes de IA.
Este texto explica a arquitetura e as decisões técnicas do projeto. Por ser um artigo público, exemplos, volumes, regras de negócio, nomes internos e dados da empresa foram deliberadamente deixados de fora. O que permanece é a parte reutilizável: como organizar fontes, relações, evidências, busca e interfaces sem construir uma caixa-preta.
Quem cuida da área de relatórios e quais problemas estão relacionados?
Buscando nas fontes
Recuperação híbrida
Resultado verificável
Área de relatórios
Time responsável identificado
Documentação, problemas abertos e histórico conectados.
O problema não era falta de informação
Quando alguém pergunta “quem é responsável por esta parte do produto?”, a resposta raramente mora em um único lugar.
O repositório mostra o código. Um catálogo descreve a tela. A documentação explica a jornada. Um sistema de trabalho registra o problema. A estrutura de times indica responsabilidade. Um histórico de mudanças pode explicar por que aquela decisão existe.
Uma busca textual encontra documentos relacionados. Ela não necessariamente explica como eles se conectam.
Nosso objetivo, portanto, não era criar mais um campo de busca. Queríamos responder perguntas que exigem atravessar relações e, ao mesmo tempo, mostrar por que cada ligação existe. A resposta precisava carregar evidência suficiente para ser verificada, contestada e atualizada.
O que o projeto resolve hoje
O Cobli Intelligence começou como uma forma de consultar conhecimento técnico, mas o grafo permitiu resolver perguntas mais próximas de decisões reais. O padrão comum é sempre o mesmo: a pergunta começa em um mundo e só ganha contexto quando atravessa outros.
Encontrar responsabilidade sem depender de memória tribal
Uma pergunta como “quem cuida desta jornada?” pode começar em uma tela do produto, alcançar o time responsável, os repositórios relacionados, a documentação e o histórico de mudanças. O resultado não é apenas um nome: é o caminho que sustenta aquela atribuição e o nível de confiança da ligação.
Isso ajuda em triagem, descoberta técnica e encaminhamento. Quando a evidência não é suficiente, o sistema mostra a lacuna em vez de inventar um responsável.
Investigar problemas pelo impacto, não apenas pela descrição
Dois tickets com textos parecidos podem ter impactos muito diferentes. O grafo permite conectar um problema ao componente afetado, à área do produto, aos sinais de uso e, quando existe uma chave confiável, ao contexto do cliente.
O objetivo não é produzir uma prioridade automática e incontestável. É montar uma fila de investigação explicável: quais sinais aumentaram a atenção, quais vieram diretamente das fontes e quais são apenas hipóteses que uma pessoa precisa validar.
Reunir a voz do cliente sem fundir identidades frágeis
Feedbacks, conversas de atendimento, interações com assistentes e eventos de produto descrevem aspectos diferentes da experiência. O projeto mantém esses corpora separados e só cria uma ponte quando existe uma identidade estável ou uma regra de curadoria explícita.
Com isso, é possível encontrar recorrências, comparar o que foi relatado com o que aconteceu no produto e chegar à área responsável sem tratar semelhança de nome ou de texto como prova de identidade.
Entender uma mudança além do diff
O código mostra o que mudou; a descrição da mudança costuma explicar por quê. Ao conectar repositório, pull request, ticket, documentação e domínio de produto, o sistema ajuda a reconstruir a história de uma decisão e a descobrir quais partes podem ser afetadas por uma nova alteração.
Dar contexto verificável a agentes de IA
Por MCP, um agente pode buscar documentação, explorar relações ou responder perguntas específicas usando o mesmo grafo. Ele recebe trechos e conexões com proveniência, em vez de uma massa de texto sem hierarquia. O modelo continua responsável por redigir a resposta; o projeto responde por recuperar e estruturar o contexto.
O modelo mental: fontes entram, relações são construídas, respostas saem
O sistema foi organizado como um pipeline com responsabilidades explícitas:
Essa separação parece simples, mas foi uma das decisões mais importantes do projeto. Buscar dados, gravar fatos, criar relações, recuperar contexto e apresentar respostas são trabalhos diferentes. Quando tudo acontece na mesma função, torna-se difícil saber se uma conexão veio da fonte, de uma regra determinística ou de uma inferência do modelo.
No código, essa divisão aparece em módulos por papel:
sources/contém os clientes das fontes externas;ingest/transforma respostas em nós, propriedades e trechos pesquisáveis;link/constrói as arestas entre os mundos;search/cuida de embeddings, recuperação, reranking e rastreamento;curation/guarda mapeamentos que precisam de julgamento humano;report/projeta o grafo em páginas, indicadores e visões de leitura.
Os pontos de entrada ficam pequenos: CLI, servidor MCP e API pública do pacote apenas orquestram essas camadas.
Quais fontes o projeto lê
As integrações se dividem entre sistemas de engenharia, produto, relacionamento, analytics e dados operacionais. O nome da ferramenta, porém, não define o modelo: cada adapter escolhe somente a fatia que possui identidade e utilidade no grafo.

GitHub
Grafo + corpusRepositórios, documentação Markdown, pull requests, times e ownership.

Jira
Grafo + corpusTickets, descrições, comentários, vínculos e referências de desenvolvimento.

Notion
Somente grafoEstrutura de times, papéis e relações organizacionais mantidas como dados.

HubSpot
Grafo + corpusContratos ativos, linhas de produto e eventos comerciais selecionados.

Databricks
Grafo + corpusAgregados de uso, inventário técnico e transcrições previamente estruturadas.

Mixpanel
Somente grafoUso mensal por jornada e rota; eventos crus não viram nós nem chunks.
Slack
Grafo + corpusFeedback estruturado, threads de conta e resumos de canais monitorados.

ClickHouse
Grafo + corpusTraces do assistente, perguntas, ferramentas utilizadas e sinais de qualidade.
Manual do produto
Corpus pesquisávelArquivos llms.txt e llms-full.txt publicados pelo próprio manual.
Mapa do produto
Somente grafoArquivo estruturado com rotas, hierarquia, documentação e ownership.
Conhecimento revisado
Corpus pesquisávelMarkdown versionado e revisado antes de entrar no índice.
Essa seleção é intencional. Do GitHub, por exemplo, documentação e descrições de pull requests viram texto pesquisável, enquanto times e ownership viram relações. Do Mixpanel entram agregados de uso por rota, não o fluxo cru de cliques. No HubSpot, contratos e produtos são fatos estruturados; somente descrições selecionadas formam corpus. No Databricks, algumas tabelas alimentam séries e inventário, enquanto transcrições podem produzir chunks.
O princípio é simples: um registro só vira corpus quando existe uma pergunta textual que ele ajuda a responder. Identificadores, valores, contagens e vínculos continuam importantes, mas pertencem ao grafo — não ao índice semântico.
Como o conteúdo é indexado
Cada corpus tem uma política própria porque a unidade útil muda conforme a fonte. Um documento técnico precisa respeitar títulos e seções; um ticket precisa manter descrição e comentários; uma conversa perde o sentido quando as respostas são separadas da pergunta inicial.
| Corpus | O que vira texto pesquisável | Âncora principal |
|---|---|---|
| Documentação técnica | Markdown dividido por seções, com pequena sobreposição | Repositório |
| Tickets | Título, descrição e comentários normalizados | Issue e componente |
| Pull requests | Título e descrição; o diff fica de fora | Repositório e issue |
| Manual do produto | Página MDX convertida para Markdown sem componentes visuais | Página do produto |
| Feedback | Campos do formulário reorganizados como relato legível | Página e, quando seguro, conta |
| Eventos de churn | Descrição textual acima de um piso mínimo de conteúdo | Conta |
| Conversas de conta | Thread inteira: mensagem inicial e respostas | Canal e conta curada |
| Assistente de IA | Pergunta do cliente e contexto limitado da resposta | Frota e página |
| Conversas de vendas | Turnos do cliente com a fala anterior como contexto | Reunião e deal |
| Canais monitorados | Resumo diário identificado como texto produzido por modelo | Canal e dia |
| Conhecimento revisado | Markdown extraído de documentos e revisado em Git | Documento de conhecimento |
O caminho até os índices segue sete decisões:
- Normalizar sem apagar significado. HTML, MDX, formatos ricos e transcrições viram texto consistente, preservando títulos, autoria relevante e procedência.
- Escolher a unidade de recuperação. A política de chunking pertence ao corpus, não a uma função genérica aplicada cegamente a tudo.
- Calcular identidade e hash. A chave do pai e a posição tornam o chunk estável; o hash evita reprocessar conteúdo que não mudou.
- Gravar o chunk no Neo4j. Texto, origem, datas e metadados ficam no mesmo grafo que contém sua entidade pai.
- Criar duas formas de busca. O texto entra em um índice full-text e recebe um embedding multilíngue em um índice vetorial exclusivo daquele corpus.
- Fundir dentro do corpus. Busca exata e vetorial são combinadas por posição; corpora de tamanhos diferentes não disputam uma lista global.
- Comparar e hidratar. Um reranker compara o lote final e o grafo acrescenta ownership, produto, impacto e proveniência.
Não armazenamos apenas um vetor. O chunk continua ligado ao documento, ticket, conversa ou página que lhe deu origem. É essa ligação que permite sair de “este trecho parece relevante” para “este trecho fala desta entidade, conectada por esta regra, com esta qualidade de evidência”.
Por que um grafo de conhecimento
O dado mais valioso do projeto não é um documento isolado. É o caminho entre entidades.
Um repositório pertence a um domínio. Uma tela é responsabilidade de um time. Um documento descreve uma parte do produto. Um ticket afeta um componente. Uma mudança resolve um problema. Essas frases já têm a forma de um grafo: substantivos viram nós; verbos viram arestas.
Escolhemos o Neo4j porque perguntas multi-hop são o caso principal, não uma exceção. A mesma base também oferece índices full-text e vetoriais, o que permite manter relações e recuperação sem criar dois universos que precisam ser sincronizados o tempo todo.
O grafo, porém, não é uma máquina de verdade. Ele só torna a origem de uma afirmação mais visível. Uma aresta errada continua sendo errada, mesmo quando aparece em uma visualização bonita. Por isso, o projeto trata a qualidade da ligação como parte do domínio.
Três classes de ligação
A regra mais importante da ontologia foi separar fatos, derivações e inferências.
Um fato é algo declarado por uma fonte: um arquivo pertence a um repositório, uma página declara seu identificador ou um registro referencia outro por uma chave estável.
Uma derivação é reproduzível. Ela pode combinar fatos por uma regra determinística, como extrair um identificador de um texto estruturado ou seguir um relacionamento já conhecido.
Uma inferência é uma aproximação: similaridade semântica, classificação por modelo ou correspondência baseada em sinais incompletos. Ela pode ser útil, mas não deve ganhar aparência de fato só porque ultrapassou um limiar numérico.
As relações carregam metadados como origem, método, confiança e versão quando necessário. Consultas podem exigir apenas ligações fortes ou incluir hipóteses como pistas. E, se um modelo ou uma regra mudar, as inferências podem ser reconstruídas sem apagar os fatos que vieram das fontes.
Isso também nos ensinou a aceitar a ausência de uma aresta. Uma lacuna honesta é melhor do que uma ligação convincente e errada que será agregada por um dashboard depois.
Cada corpus precisa de sua própria ponte
Não criamos um “conector universal”. Cada fonte tem identidade, cadência e modos de falha próprios.
Um adapter sabe autenticar, paginar e traduzir o contrato externo. A ingestão sabe qual identidade torna um registro idempotente. A camada de ligação sabe quais chaves podem atravessar a fronteira entre dois sistemas. Esse desenho impede que detalhes de API vazem para a ontologia inteira.
Para conteúdo textual, guardamos o documento original e seus chunks. Um hash do conteúdo evita reprocessar o que não mudou; o modo incremental retoma a partir de marcas conhecidas; o prune remove o que desapareceu na origem. Reexecutar o pipeline deve convergir para o mesmo estado, não multiplicar registros.
Também mantemos corpora diferentes em índices vetoriais separados. Documentação, tickets e histórico de mudanças têm distribuições e volumes muito diferentes. Se tudo disputar o mesmo ranking, o corpus mais numeroso domina a resposta mesmo quando não é o mais confiável para aquela pergunta.
Essa separação resolve dois problemas ao mesmo tempo. O primeiro é estatístico: uma fonte muito volumosa deixa de soterrar corpora menores. O segundo é semântico: um trecho de documentação e um relato de problema podem ser relevantes para a mesma pergunta sem significar a mesma coisa. O grafo preserva essa diferença enquanto permite que os dois apareçam na mesma investigação.
Busca semântica sozinha não bastava
Embeddings são ótimos para encontrar paráfrases e atravessar português e inglês. Mas nomes de serviços, variáveis, códigos e identificadores exatos são justamente o tipo de coisa que uma busca vetorial pode diluir.
Por isso, a recuperação padrão é híbrida:
- uma busca vetorial recupera proximidade semântica;
- uma busca full-text encontra termos exatos;
- os rankings são combinados por reciprocal rank fusion;
- um reranker reordena o conjunto mais promissor;
- o grafo expande cada resultado com o contexto conectado que a resposta precisa.
O resultado não é apenas um trecho parecido com a pergunta. Ele pode chegar acompanhado do documento de origem, do repositório relacionado, da responsabilidade conhecida e do tipo de evidência usado para fazer a conexão.
Hoje usamos embeddings multilíngues e reranking por cross-encoder. Os provedores são intercambiáveis: o pipeline pode usar modelos hospedados ou variantes locais em ONNX. Essa flexibilidade foi importante tanto para custo e latência quanto para manter o núcleo da aplicação independente de um fornecedor específico.
Como uma pergunta é resolvida de ponta a ponta
Considere uma pergunta deliberadamente genérica: “qual problema aberto merece ser investigado primeiro?”. Ela não pode ser respondida por similaridade textual apenas.
Primeiro, a consulta é preparada em duas formas. A representação vetorial encontra paráfrases e conceitos próximos; a representação textual preserva identificadores e termos exatos. Cada corpus produz sua própria lista, e a reciprocal rank fusion combina posições sem fingir que cosseno e relevância textual estão na mesma escala.
Depois do reranking, os candidatos ainda são somente trechos. A hidratação no grafo traz as entidades ao redor: componente, página, responsabilidade, sinais relacionados e proveniência. Só então a aplicação possui material para montar uma fila de investigação ou entregar contexto a um agente.
Esse trace é parte do produto. Ele permite verificar quantos candidatos entraram e saíram de cada etapa, qual corpus contribuiu e por que uma evidência chegou à resposta. A explicação executa as mesmas consultas e cálculos da busca real; não existe uma segunda implementação simplificada apenas para a interface.
O LLM não mora no centro da arquitetura
O Cobli Intelligence não precisa escolher o modelo que redige a resposta final.
O projeto recupera fatos, relações e trechos. O cliente que chamou a ferramenta decide como transformar esse contexto em linguagem natural. Essa fronteira evita duplicar uma camada de chat dentro do sistema e permite que diferentes agentes usem a mesma base.
O protocolo que tornou isso prático foi o Model Context Protocol (MCP). O servidor expõe ferramentas tipadas para busca, exploração e consultas específicas. Em vez de entregar acesso irrestrito ao banco, cada ferramenta oferece um contrato menor, validado e observável.
Essa escolha também muda a função do grafo. Ele não é “memória do modelo”. É infraestrutura de contexto: uma fonte consultável que continua existindo independentemente de qual agente esteja conectado a ela.
O dashboard não é só uma vitrine
O segundo consumidor é uma aplicação em Next.js e React. Ela permite navegar pelo grafo, inspecionar fontes, acompanhar a execução do pipeline e entender como uma conclusão foi formada.
A parte mais importante do dashboard não é a visualização de nós. É a explicação.
Quando uma regra de peso, um limiar ou um tipo de relação muda, a documentação visível precisa mudar junto. Caso contrário, a interface passa a comunicar uma confiança que o sistema já não sustenta. Por isso, constantes compartilhadas alimentam tanto a execução quanto as páginas que descrevem o pipeline, e testes cobram a cobertura da ontologia e do catálogo de tarefas.
Tratamos essas páginas como um manual operacional vivo. Elas mostram o que existe, de onde vem, quando foi atualizado e o que ficou de fora. O dashboard é parte do mecanismo de confiança, não apenas uma camada de apresentação.
A stack
O projeto é um monorepo com Bun, TypeScript e Turborepo. A aplicação de inteligência e o dashboard vivem em workspaces separados, mas compartilham contratos e constantes leves.
Na prática, a stack principal é:
- Bun e TypeScript para CLI, ingestão, jobs e servidor MCP;
- Turborepo para organizar build, testes e typecheck entre os workspaces;
- Neo4j, executado em Docker, para o grafo e os índices vetoriais e full-text;
- embeddings multilíngues e reranking por cross-encoder, com opções hospedadas e locais;
- MCP SDK para oferecer o grafo a agentes por ferramentas tipadas;
- Next.js, React e Tailwind CSS para o dashboard;
- Zod para validar os contratos nas fronteiras do sistema.
Também separamos a API de leitura leve da pipeline que carrega modelos e runtime ONNX. Uma página que só consulta o grafo não deveria pagar o custo de inicializar um modelo de recuperação. Essa fronteira de imports reduziu acoplamento e tornou o comportamento de cada processo mais previsível.
Operar a ingestão também faz parte do produto
Um grafo desatualizado pode responder com segurança aparente. Por isso, freshness e execução não ficaram escondidas em scripts soltos.
Os passos do pipeline vivem em um catálogo que declara ordem, dependências, argumentos aceitos e o que cada tarefa escreve. Execuções manuais e agendadas passam pela mesma fila global e produzem o mesmo formato de log. Se uma carga ainda está em andamento, a próxima marca do relógio é registrada como pulada em vez de iniciar duas escritas concorrentes.
Essa decisão custa algum código operacional, mas elimina uma classe difícil de diagnosticar: duas pipelines individualmente “corretas” produzindo, juntas, um estado que nenhuma delas representa.
Os testes cobrem tanto transformações quanto regras de integridade. Para integração, um Neo4j descartável evita que a suíte dependa do estado da base de desenvolvimento ou altere dados já carregados.
O que aprendemos
Modele a evidência antes de modelar a resposta
Começar pelo prompt teria produzido um assistente impressionante e difícil de auditar. Começar pelas identidades, relações e graus de confiança criou uma base que pode servir a muitos consumidores.
Nem toda similaridade merece virar aresta
Busca pode trabalhar com aproximações porque o usuário ainda escolhe um resultado. Uma aresta será percorrida, contada e agregada como parte do domínio. O limiar para gravá-la precisa ser muito mais alto.
Curadoria explícita não é fracasso de automação
Algumas pontes exigem conhecimento humano que nenhuma fonte declara. Guardar essa curadoria como dado versionado, com justificativa e testes, é melhor do que esconder a mesma opinião dentro de um prompt.
A explicação precisa usar o mesmo caminho da execução
Uma página que reimplementa a lógica para “explicá-la” inevitavelmente diverge. Sempre que possível, a visualização e o trace reutilizam as mesmas constantes, consultas e cálculos da pipeline real.
O valor aparece nas conexões
Indexar documentos foi o começo. O ganho real veio quando uma pergunta passou a atravessar código, produto, responsabilidade e histórico sem perder a origem de cada passo.
Onde chegamos
O Cobli Intelligence tornou-se uma camada comum entre conhecimento organizacional, interfaces humanas e agentes de IA.
Ele não tenta substituir os sistemas de origem nem declarar uma verdade absoluta sobre a empresa. Sua função é conectar o que cada sistema já sabe, deixar explícito como cada ponte foi construída e entregar contexto verificável no lugar onde uma decisão acontece.
Essa é, para mim, a principal diferença entre simplesmente colocar documentos em um vetor e construir infraestrutura de inteligência: a resposta pode até terminar em texto, mas a confiança nasce do caminho que conseguimos mostrar até ela.